科技深邃深蓝色背景的Atlas世界模型技术解析图,竖版3:4比… - 图片创意预览

科技深邃深蓝色背景的Atlas世界模型技术解析图,竖版3:4比…

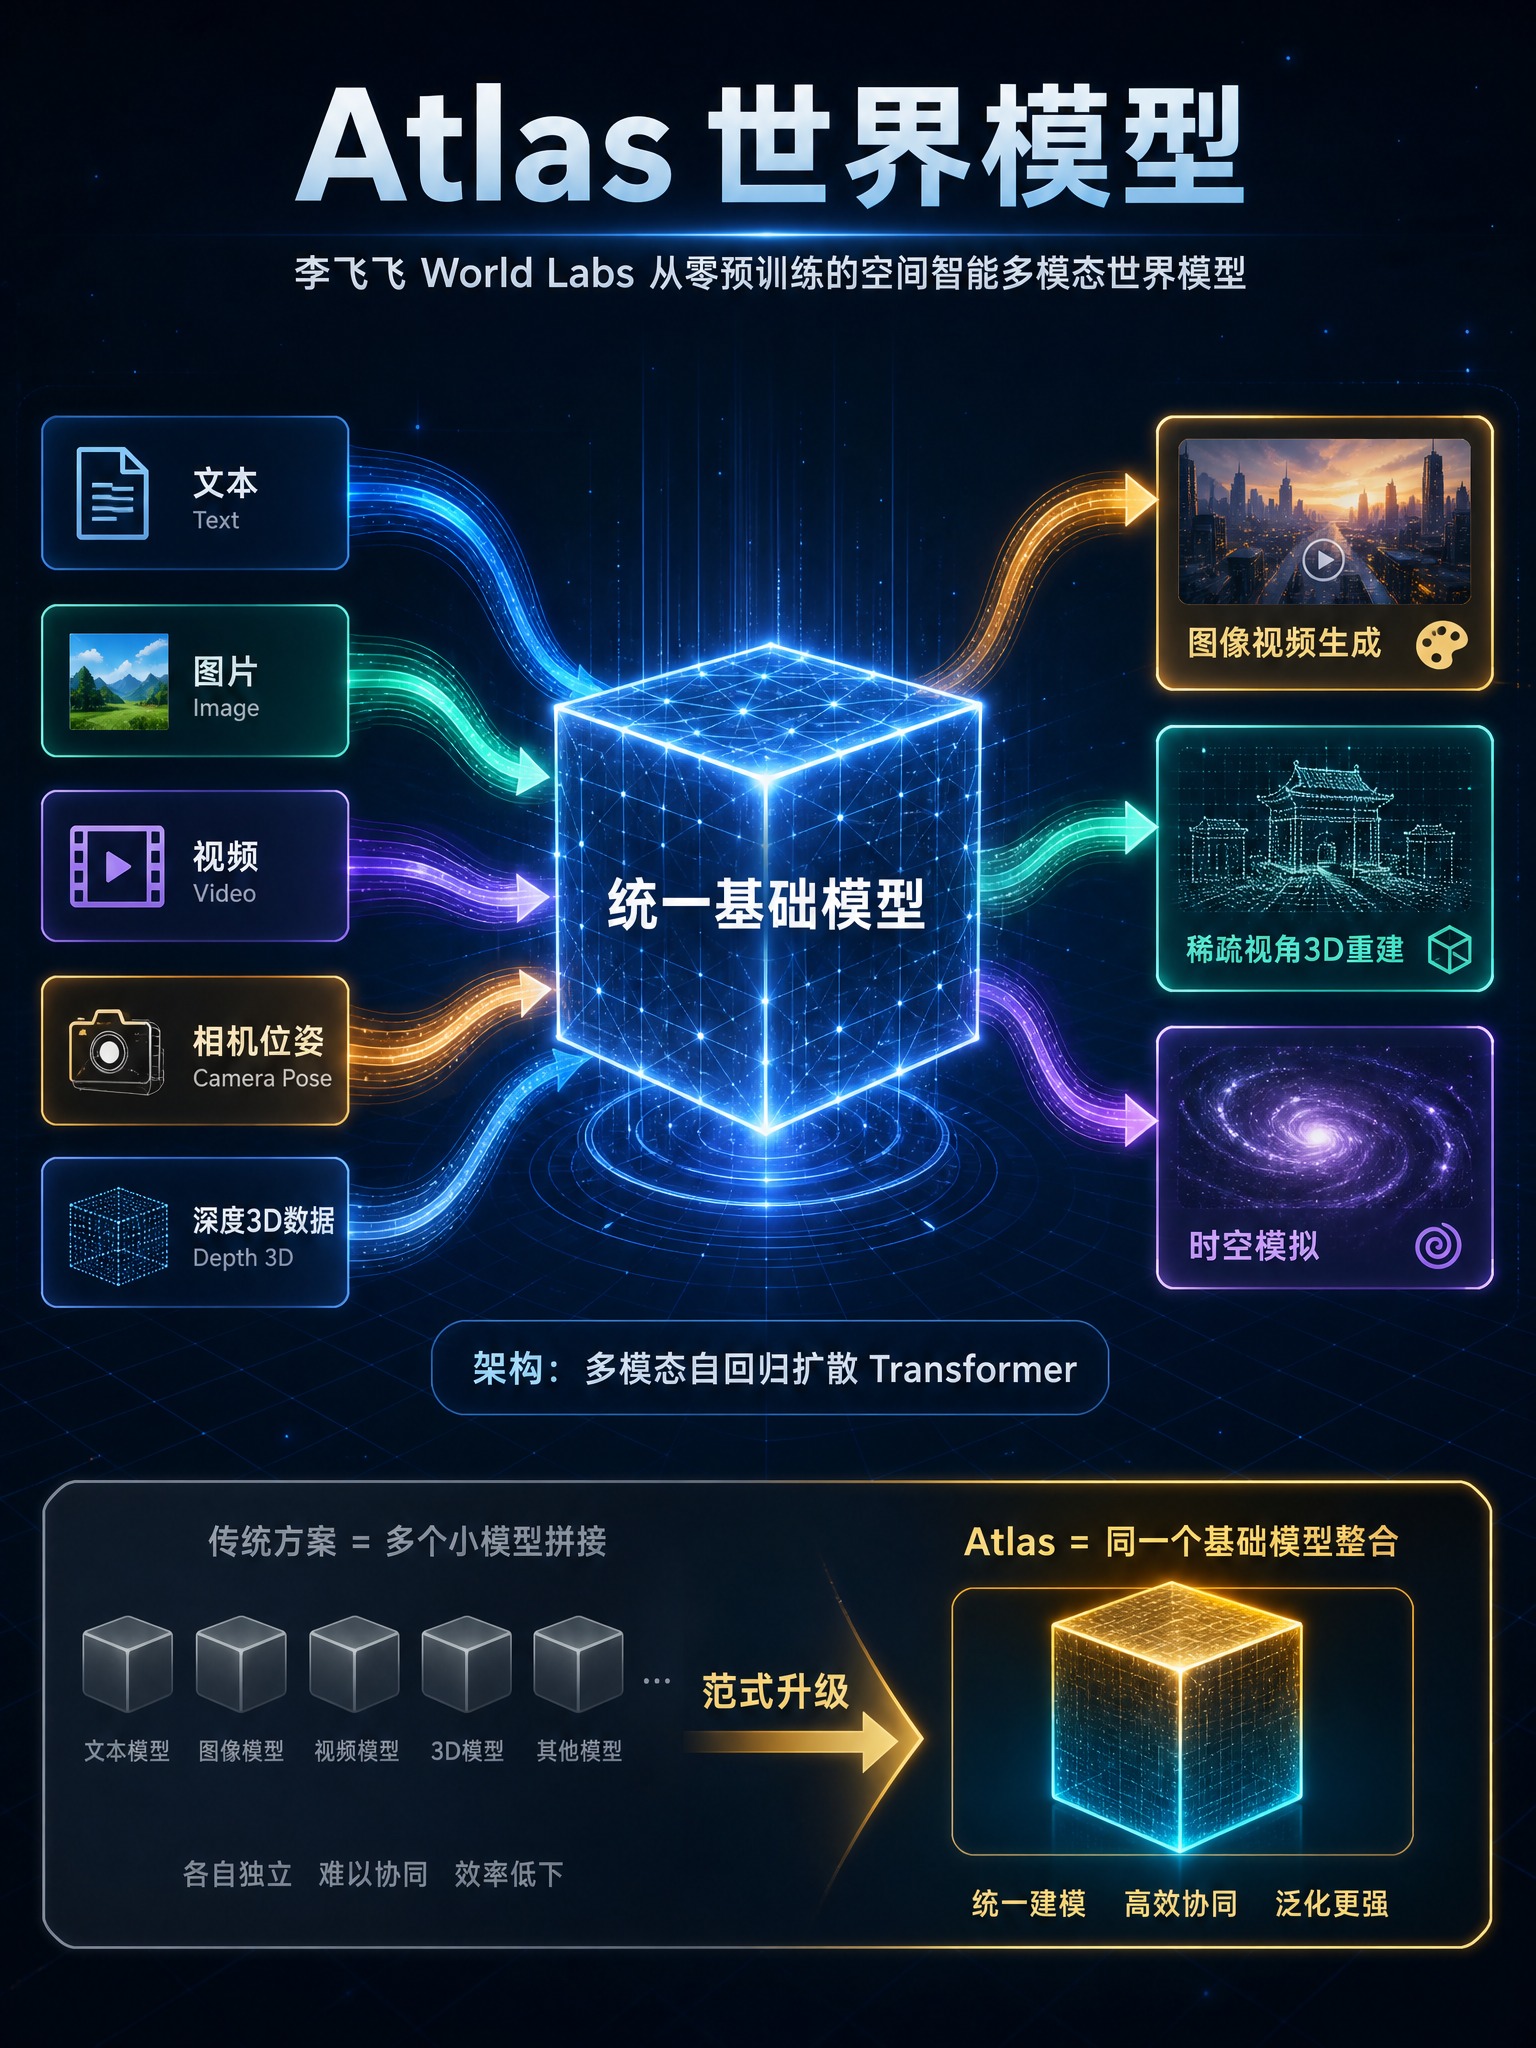
科技深邃深蓝色背景的Atlas世界模型技术解析图,竖版3:4比例,2K超清。延续上一张的赛博科技风,极简高级质感,画面干净,居中布局,无多余杂物。 顶部标题:"Atlas 世界模型" 副标题:"李飞
用户头像

67rn073cr2j...

2026.09.03
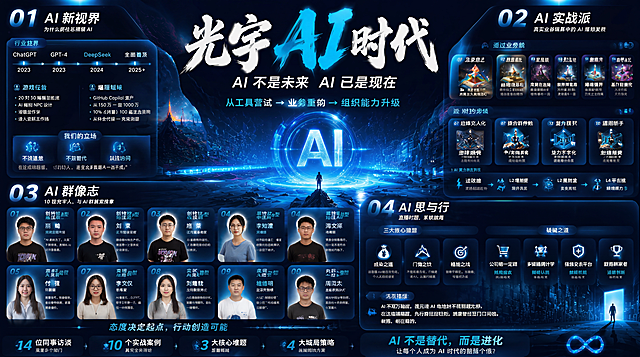
科技深邃深蓝色背景的Atlas三大核心能力解析图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。 顶部大标题:"三大炸裂核心能力" 副标题小字:"Atlas 世界模型 · 重新定义空间智能" 画面主体是三大能力卡片,从上到下依次排列,每张卡片有编号、图标、能力名称和核心描述: 【01 像素级相机可控生成】 - 图标:相机轨迹线+视频帧序列,展示从几张照片生成连贯视频的过程 - 核心文字:"输入1-6张普通照片 + 给定相机运动坐标轨迹 | 直接生成最长1分钟、1440P连贯视频 | 镜头运动几何保持一致 | 不再依靠文字prompt碰运气式运镜" - 标签:"🎬 可控视频生成 · 几何精准" 【02 稀疏空间重建】 - 图标:少量照片输入 → 3D点云/高斯泼溅模型输出的示意图 - 核心文字:"少量图片即可输出显式3D表征(点云、3D高斯泼溅) | 单张图片就能脑补出拍摄盲区的物体背面、周边环境 | 稀疏视角重建效果超过很多专门做3D重建的模型" - 标签:"🏗️ 3D重建 · 单图脑补" 【03 Real-to-Sim 真实转仿真】 - 图标:真实照片/视频 → 转化为机器人虚拟仿真环境的双向箭头 - 核心文字:"把现实拍摄的照片/视频,直接转化为机器人可用的虚拟仿真环境 | 自动输出机器人传感器会看到的RGB画面与深度数据 | 打通真实世界到数字仿真的链路" - 标签:"🤖 实转仿真 · 机器人训练底座" 整体视觉: - 深邃藏蓝色背景,3D空间网格线,粒子光效 - 每张卡片用发光边框呈现,编号用金色或蓝绿色高亮 - 图标用全息半透明风格,科技感十足 - 文字清晰,层级分明 - 极简高级,小红书硬核科普风格科技深邃深蓝色背景的Atlas三大核心能力解析图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。

顶部大标题:"三大炸裂核心能力"
副标题小字:"Atlas 世界模型 · 重新定义空间智能"

画面主体是三大能力卡片,从上到下依次排列,每张卡片有编号、图标、能力名称和核心描述:

【01 像素级相机可控生成】
- 图标:相机轨迹线+视频帧序列,展示从几张照片生成连贯视频的过程
- 核心文字:"输入1-6张普通照片 + 给定相机运动坐标轨迹 | 直接生成最长1分钟、1440P连贯视频 | 镜头运动几何保持一致 | 不再依靠文字prompt碰运气式运镜"
- 标签:"🎬 可控视频生成 · 几何精准"

【02 稀疏空间重建】
- 图标:少量照片输入 → 3D点云/高斯泼溅模型输出的示意图
- 核心文字:"少量图片即可输出显式3D表征(点云、3D高斯泼溅) | 单张图片就能脑补出拍摄盲区的物体背面、周边环境 | 稀疏视角重建效果超过很多专门做3D重建的模型"
- 标签:"🏗️ 3D重建 · 单图脑补"

【03 Real-to-Sim 真实转仿真】
- 图标:真实照片/视频 → 转化为机器人虚拟仿真环境的双向箭头
- 核心文字:"把现实拍摄的照片/视频,直接转化为机器人可用的虚拟仿真环境 | 自动输出机器人传感器会看到的RGB画面与深度数据 | 打通真实世界到数字仿真的链路"
- 标签:"🤖 实转仿真 · 机器人训练底座"

整体视觉:
- 深邃藏蓝色背景,3D空间网格线,粒子光效
- 每张卡片用发光边框呈现,编号用金色或蓝绿色高亮
- 图标用全息半透明风格,科技感十足
- 文字清晰,层级分明
- 极简高级,小红书硬核科普风格
科技深邃深蓝色背景的世界模型路线对比图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。 顶部大标题:"和其他世界模型路线对比" 副标题小字:"Cosmos vs Atlas · 两条互补路线,各有所长" 画面主体是左右两大对比板块,中间用一条发光竖线分隔: 【左侧:英伟达 Cosmos】 主色调:绿色/青色系(呼应英伟达品牌色) - 顶部图标:物理公式、碰撞粒子、动力学模拟的抽象图形 - 标题大字:"Cosmos" - 副标题:"英伟达 · 物理AI路线" - 核心定位:"偏向给虚拟世界写物理规则" - 能力列表: ✅ 强项:动力学模拟 · 碰撞检测 · 物理规则生成 · 物体交互逻辑 ⚠️ 侧重:物理规则的准确性与交互真实性 - 底部标签:"🔬 物理规则派" 【右侧:Atlas】 主色调:蓝色/金色系 - 顶部图标:3D空间网格、相机轨迹、照片重建场景的抽象图形 - 标题大字:"Atlas" - 副标题:"李飞飞 World Labs · 空间智能路线" - 核心定位:"偏向把现实世界复刻进虚拟空间" - 能力列表: ✅ 强项:稀疏视角3D几何重建 · 相机可控长视频生成 · 现实照片还原空间 ⚠️ 局限:物理动力学非长板 · 碰撞/摩擦/形变等物理规则仍有局限 - 底部标签:"🌍 空间复刻派" 画面底部总结板块: 用金蓝色渐变的结论卡片: 标题:"简单概括" 内容: "Cosmos = 给虚拟世界写物理规则 Atlas = 把现实世界复刻进虚拟空间 二者是具身智能世界模型的两条互补路线" 整体视觉:深邃藏蓝色背景,3D空间网格线,粒子光效,左右两侧用不同色调区分,卡片发光边框,文字清晰层级分明,极简高级,硬核科普风格。科技深邃深蓝色背景的世界模型路线对比图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。

顶部大标题:"和其他世界模型路线对比"
副标题小字:"Cosmos vs Atlas · 两条互补路线,各有所长"

画面主体是左右两大对比板块,中间用一条发光竖线分隔:

【左侧:英伟达 Cosmos】
主色调:绿色/青色系(呼应英伟达品牌色)
- 顶部图标:物理公式、碰撞粒子、动力学模拟的抽象图形
- 标题大字:"Cosmos"
- 副标题:"英伟达 · 物理AI路线"
- 核心定位:"偏向给虚拟世界写物理规则"
- 能力列表:
  ✅ 强项:动力学模拟 · 碰撞检测 · 物理规则生成 · 物体交互逻辑
  ⚠️ 侧重:物理规则的准确性与交互真实性
- 底部标签:"🔬 物理规则派"

【右侧:Atlas】
主色调:蓝色/金色系
- 顶部图标:3D空间网格、相机轨迹、照片重建场景的抽象图形
- 标题大字:"Atlas"
- 副标题:"李飞飞 World Labs · 空间智能路线"
- 核心定位:"偏向把现实世界复刻进虚拟空间"
- 能力列表:
  ✅ 强项:稀疏视角3D几何重建 · 相机可控长视频生成 · 现实照片还原空间
  ⚠️ 局限:物理动力学非长板 · 碰撞/摩擦/形变等物理规则仍有局限
- 底部标签:"🌍 空间复刻派"

画面底部总结板块:
用金蓝色渐变的结论卡片:
标题:"简单概括"
内容:
"Cosmos = 给虚拟世界写物理规则
Atlas = 把现实世界复刻进虚拟空间

二者是具身智能世界模型的两条互补路线"

整体视觉:深邃藏蓝色背景,3D空间网格线,粒子光效,左右两侧用不同色调区分,卡片发光边框,文字清晰层级分明,极简高级,硬核科普风格。
科技深邃深蓝色背景的Atlas具身智能价值解析图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。 顶部大标题:"对具身智能机器人的关键价值" 副标题小字:"解决 Real-to-Sim 痛点 · 打通虚实鸿沟" 画面分为上下两大区域: 【上部:传统痛点 vs Atlas新范式】 左右对比布局: 左侧(传统方案,灰色/暗红色调,标注"痛点"): 标题:"传统方案的困境" - 痛点1:"真机数据成本极高"——真机试错有损耗、安全风险 - 痛点2:"人工建模效率低"——Isaac Sim等仿真引擎需人工建模场景 - 痛点3:"Sim2Real虚实鸿沟"——仿真练的动作落地真机经常失效 图标:断开的虚实连接桥梁 右侧(Atlas方案,蓝绿色/金色调,标注"新范式"): 标题:"Atlas Real-to-Sim 新范式" 四步流程图(箭头连接): ① 现实拍几张照片/一段视频 → ② Atlas重建完整3D仿真环境 → ③ 机器人在虚拟空间训练导航、抓取策略 → ④ 迁移回真实硬件 图标:完整连接的虚实双向通道 【下部:三大核心价值】 三个价值卡片,从上到下排列: 1. 「大幅降低机器人场景数据成本」 图标:手机拍照 → 批量生成虚拟场景 文字:"工厂、家庭、商超等非结构化环境 | 不用人工搭建三维仿真工程 | 手机拍摄少量素材,快速生成大量训练虚拟场景 | 长尾、危险场景可批量生成样本" 2. 「视觉一致性更强」 图标:真实照片与仿真渲染的对比,相似度极高 文字:"传统仿真渲染光影、纹理与现实脱节 | Atlas源自真实图像重建 | 视觉观感贴近真实 | 缩小仿真与现实的视觉域差" 3. 「统一感知与仿真底座」 图标:一套模型同时连接"现实感知"和"仿真生成" 文字:"传统方案:感知模型做识别 + 第三方仿真引擎做环境(两套系统) | Atlas:一套模型既看懂现实,又生成仿真画面 | 感知与仿真出自同一套空间理解 | 减少两套系统带来的偏差" 整体视觉:深邃藏蓝色背景,3D空间网格线,粒子光效,卡片发光边框,文字清晰层级分明,极简高级,硬核科普风格。科技深邃深蓝色背景的Atlas具身智能价值解析图,竖版3:4比例,2K超清。延续深蓝赛博科技风,极简高级质感,画面干净,无多余杂物。

顶部大标题:"对具身智能机器人的关键价值"
副标题小字:"解决 Real-to-Sim 痛点 · 打通虚实鸿沟"

画面分为上下两大区域:

【上部:传统痛点 vs Atlas新范式】
左右对比布局:

左侧(传统方案,灰色/暗红色调,标注"痛点"):
标题:"传统方案的困境"
- 痛点1:"真机数据成本极高"——真机试错有损耗、安全风险
- 痛点2:"人工建模效率低"——Isaac Sim等仿真引擎需人工建模场景
- 痛点3:"Sim2Real虚实鸿沟"——仿真练的动作落地真机经常失效
图标:断开的虚实连接桥梁

右侧(Atlas方案,蓝绿色/金色调,标注"新范式"):
标题:"Atlas Real-to-Sim 新范式"
四步流程图(箭头连接):
① 现实拍几张照片/一段视频
→ ② Atlas重建完整3D仿真环境
→ ③ 机器人在虚拟空间训练导航、抓取策略
→ ④ 迁移回真实硬件
图标:完整连接的虚实双向通道

【下部:三大核心价值】
三个价值卡片,从上到下排列:

1. 「大幅降低机器人场景数据成本」
   图标:手机拍照 → 批量生成虚拟场景
   文字:"工厂、家庭、商超等非结构化环境 | 不用人工搭建三维仿真工程 | 手机拍摄少量素材,快速生成大量训练虚拟场景 | 长尾、危险场景可批量生成样本"

2. 「视觉一致性更强」
   图标:真实照片与仿真渲染的对比,相似度极高
   文字:"传统仿真渲染光影、纹理与现实脱节 | Atlas源自真实图像重建 | 视觉观感贴近真实 | 缩小仿真与现实的视觉域差"

3. 「统一感知与仿真底座」
   图标:一套模型同时连接"现实感知"和"仿真生成"
   文字:"传统方案:感知模型做识别 + 第三方仿真引擎做环境(两套系统) | Atlas:一套模型既看懂现实,又生成仿真画面 | 感知与仿真出自同一套空间理解 | 减少两套系统带来的偏差"

整体视觉:深邃藏蓝色背景,3D空间网格线,粒子光效,卡片发光边框,文字清晰层级分明,极简高级,硬核科普风格。
科技深邃深蓝色背景的AI第二赛道宣言海报,竖版3:4比例,2K超清。赛博科技风,极简高级质感,画面干净,宏大叙事感。 顶部大标题:"世界模型正式成为 AI 的第二赛道" 副标题小字:"从语言智能到空间智能 · AI竞争下半场" 画面中心是一个宏大的视觉意象: - 左侧是一个发光的大脑/语言模型图标(文字、对话气泡符号),标注"第一赛道:大语言模型",颜色偏蓝白色 - 右侧是一个发光的3D世界/空间网格图标(空间、物理、3D符号),标注"第二赛道:世界模型",颜色偏金蓝色 - 中间有一条发光的赛道线,从左侧延伸向右侧,象征赛道转移 - 赛道上方有一个箭头,写着"竞争方向转移" 画面中部有一段核心论述文字(居中排版): "大语言模型学会处理文字; 世界模型目标让 AI 真正理解空间、物理世界。 过去比拼:上下文 · 推理能力 接下来比拼:空间理解 · 三维重建 · 虚实转换 · 物理仿真" 画面底部是标志性意义(金色高亮): "新一代世界模型发布的标志意义: 世界模型不再只是概念 已经产出可给机器人、内容产业使用的工程化底座 具身智能的竞争 底层已经变成世界模型能力的竞争" 整体视觉: - 深邃藏蓝色背景,3D空间网格线向远方延伸 - 粒子光效、柔光弥散,宏大空间感 - 左右赛道对比清晰,右侧第二赛道更亮更醒目 - 文字清晰,层级分明,金句突出 - 极简高级,行业宣言海报质感科技深邃深蓝色背景的AI第二赛道宣言海报,竖版3:4比例,2K超清。赛博科技风,极简高级质感,画面干净,宏大叙事感。

顶部大标题:"世界模型正式成为 AI 的第二赛道"
副标题小字:"从语言智能到空间智能 · AI竞争下半场"

画面中心是一个宏大的视觉意象:
- 左侧是一个发光的大脑/语言模型图标(文字、对话气泡符号),标注"第一赛道:大语言模型",颜色偏蓝白色
- 右侧是一个发光的3D世界/空间网格图标(空间、物理、3D符号),标注"第二赛道:世界模型",颜色偏金蓝色
- 中间有一条发光的赛道线,从左侧延伸向右侧,象征赛道转移
- 赛道上方有一个箭头,写着"竞争方向转移"

画面中部有一段核心论述文字(居中排版):
"大语言模型学会处理文字;
世界模型目标让 AI 真正理解空间、物理世界。

过去比拼:上下文 · 推理能力
接下来比拼:空间理解 · 三维重建 · 虚实转换 · 物理仿真"

画面底部是标志性意义(金色高亮):
"新一代世界模型发布的标志意义:
世界模型不再只是概念
已经产出可给机器人、内容产业使用的工程化底座

具身智能的竞争
底层已经变成世界模型能力的竞争"

整体视觉:
- 深邃藏蓝色背景,3D空间网格线向远方延伸
- 粒子光效、柔光弥散,宏大空间感
- 左右赛道对比清晰,右侧第二赛道更亮更醒目
- 文字清晰,层级分明,金句突出
- 极简高级,行业宣言海报质感
电商详情页设计,第4页·多模态模型能力,3:4竖版比例,高端科技服务风格。 [画面] 页面目标:展示7大多模态模型技术栈,体现技术深度。顶部是标题区域,中部中心有一个发光的AI技术核心球体,科技蓝渐变发光,周围环绕7个模型技术节点,用发光的点线连接成环形网络。每个节点是一个圆形发光图标,内有对应模型的图标符号和名称文字。7个节点均匀分布在核心球体周围,形成一个完整的技术能力矩阵。 [视觉] 套系策略:风格=高端科技服务风;标题字=现代无衬线粗黑体;正文字=简洁无衬线体;主色=科技蓝;背景延展=白色到浅蓝灰渐变,带极淡科技网格纹理和稀疏蓝色光点粒子;强调色=青色和淡紫渐变,仅用于图标和发光效果;标题色=科技蓝;正文色=深灰;组件=发光圆形节点、细线图标、发光连接线;光影=柔和科技光效,节点有发光边缘和光晕。 [文字] 顶部居中主标题"多模态模型能力矩阵",科技蓝色粗体,字号大;主标题下方一行副标题"覆盖文本 图像 语音 视频全模态AI技术栈",深灰色,字号约为主标题的40%。 7个模型技术节点(环绕排列): 1. LLM语言模型 - 自然语言理解与生成 - 文字/对话图标 2. CNN图片模型 - 图像识别与分类 - 图片/分类图标 3. ViT视觉模型 - 高精度视觉感知 - 眼睛/视觉图标 4. ASR语音识别 - 语音转文字 多语种支持 - 麦克风/声波图标 5. TTS语音合成 - 文字转自然语音 - 喇叭/语音图标 6. VGM视频生成 - AI视频内容创作 - 视频/播放图标 7. AI 3D模型 - 三维内容生成与重建 - 立方体/3D图标 每个节点名称为白色粗体在蓝色圆形内,说明文字为深灰色在节点下方或旁边。所有文字横排,清晰可读。 [规格] 比例3:4竖版,4K分辨率,避免变形、错字、文字过小、二维码、水印、模仿官方logo、背景杂乱、低清晰度。电商详情页设计,第4页·多模态模型能力,3:4竖版比例,高端科技服务风格。

[画面] 页面目标:展示7大多模态模型技术栈,体现技术深度。顶部是标题区域,中部中心有一个发光的AI技术核心球体,科技蓝渐变发光,周围环绕7个模型技术节点,用发光的点线连接成环形网络。每个节点是一个圆形发光图标,内有对应模型的图标符号和名称文字。7个节点均匀分布在核心球体周围,形成一个完整的技术能力矩阵。

[视觉] 套系策略:风格=高端科技服务风;标题字=现代无衬线粗黑体;正文字=简洁无衬线体;主色=科技蓝;背景延展=白色到浅蓝灰渐变,带极淡科技网格纹理和稀疏蓝色光点粒子;强调色=青色和淡紫渐变,仅用于图标和发光效果;标题色=科技蓝;正文色=深灰;组件=发光圆形节点、细线图标、发光连接线;光影=柔和科技光效,节点有发光边缘和光晕。

[文字] 顶部居中主标题"多模态模型能力矩阵",科技蓝色粗体,字号大;主标题下方一行副标题"覆盖文本 图像 语音 视频全模态AI技术栈",深灰色,字号约为主标题的40%。

7个模型技术节点(环绕排列):
1. LLM语言模型 - 自然语言理解与生成 - 文字/对话图标
2. CNN图片模型 - 图像识别与分类 - 图片/分类图标
3. ViT视觉模型 - 高精度视觉感知 - 眼睛/视觉图标
4. ASR语音识别 - 语音转文字 多语种支持 - 麦克风/声波图标
5. TTS语音合成 - 文字转自然语音 - 喇叭/语音图标
6. VGM视频生成 - AI视频内容创作 - 视频/播放图标
7. AI 3D模型 - 三维内容生成与重建 - 立方体/3D图标

每个节点名称为白色粗体在蓝色圆形内,说明文字为深灰色在节点下方或旁边。所有文字横排,清晰可读。

[规格] 比例3:4竖版,4K分辨率,避免变形、错字、文字过小、二维码、水印、模仿官方logo、背景杂乱、低清晰度。
参照这张图的低饱和深空蓝科技插画风格,生成一张新的算力与存储负载对比信息图,竖版3:4构图,2K超清: 顶部大标题:"静态图像 vs AI 视频" 副标题小字:"算力与存储负载,完全不在一个量级" 画面主体分为左右两大对比区: 【左侧(灰色调):静态图像】 图标:单帧画面卡片 内容:"模型只需处理一帧画面 | 一次性计算画面内物体、光影、纹理特征 | 计算完成后大部分临时数据可以直接释放" 标签:"单帧处理 · 数据可释放" 【右侧(青蓝高亮):AI 视频】 图标:连续帧胶片序列 + 存储数据块堆叠 内容:"每秒包含十余帧连续画面 | 不只是重复一张一张画图 | 模型必须持续记住场景里全部实体信息:人物五官、服装纹理、道具位置、空间结构、光影方向 | 每一帧生成时都要读取历史帧特征做比对、对齐、约束,防止画面跳变" 标签:"连续帧 · 持续记忆与校验" 画面下部重点说明卡片(金色渐变边框): 标题:"长镜头的真实代价" 内容:"长镜头持续时间越长,需要保存在高速存储里的特征数据就越多 | 相当于持续在内存里维护一套动态的虚拟世界档案,不断读写、校验、修正" 底部金句条(金色渐变): "AI 视频不是画得更慢,而是不得不同时养活一整套动态世界模型" 保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。参照这张图的低饱和深空蓝科技插画风格,生成一张新的算力与存储负载对比信息图,竖版3:4构图,2K超清:

顶部大标题:"静态图像 vs AI 视频"
副标题小字:"算力与存储负载,完全不在一个量级"

画面主体分为左右两大对比区:

【左侧(灰色调):静态图像】
图标:单帧画面卡片
内容:"模型只需处理一帧画面 | 一次性计算画面内物体、光影、纹理特征 | 计算完成后大部分临时数据可以直接释放"
标签:"单帧处理 · 数据可释放"

【右侧(青蓝高亮):AI 视频】
图标:连续帧胶片序列 + 存储数据块堆叠
内容:"每秒包含十余帧连续画面 | 不只是重复一张一张画图 | 模型必须持续记住场景里全部实体信息:人物五官、服装纹理、道具位置、空间结构、光影方向 | 每一帧生成时都要读取历史帧特征做比对、对齐、约束,防止画面跳变"
标签:"连续帧 · 持续记忆与校验"

画面下部重点说明卡片(金色渐变边框):
标题:"长镜头的真实代价"
内容:"长镜头持续时间越长,需要保存在高速存储里的特征数据就越多 | 相当于持续在内存里维护一套动态的虚拟世界档案,不断读写、校验、修正"

底部金句条(金色渐变):
"AI 视频不是画得更慢,而是不得不同时养活一整套动态世界模型"

保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。
一张16:9横版的多模态AI与AI影视产业全景信息图海报,科技感商务风格,深蓝与紫色渐变背景,带有发光的神经网络节点和数据流线条装饰,整体高端专业。画面分为三大横向模块,版式精美,信息层次分明。 顶部居中大标题:"多模态AI与AI影视产业全景",字体粗大有力量,下方副标题:"能力爆发 · 三级落地 · 从1到N放量关键时点",字号稍小。 左侧模块(模块一):标题"近期模型密集升级",下方以时间轴或卡片形式列出5个模型升级事件,每个事件配小图标: - "DeepSeek VC Flash专业版" 视觉理解Agent能力跃升 - "阿里万相3.0" 单次生成30秒视频 - "智谱GLM5.3 Flash" 3200亿参数 定价仅1/10 - "腾讯混元4 Preview" 7700亿参数 1M上下文 - "MiniMax H3 Max" 实时直播 跨过直播门槛 中间模块(模块二):标题"AI影视三层落地路径",用三个阶梯式或递进式卡片展示,从下到上或从左到右: - 第一层:"AI短剧/漫剧" 标注"已大规模成熟·数百亿市场" - 第二层:"AI长剧" 标注"《后西游记》卫视上线·标志性落地" - 第三层:"AI电影" 标注"《三星堆》2026院线·起步潜力巨大" 每个层级用箭头连接表示递进关系。 右侧模块(模块三):标题"产业链核心标的",分为上下两部分: - 上半部分:"视频模型工具(卖水人逻辑)" 列出:快手可灵、腾讯混元、MiniMax H3、阿里万相、智谱GLM5 - 下半部分:"AI影视内容" 列出:阅文集团、芒果超媒、博纳影业、光线传媒、掌阅科技 底部有一行标签式文字:"多模态弯道超车 · 国产模型原生优势 · 商业化空间全面打开"。 整体配色:深蓝紫色调为主,搭配青色和橙色点缀,科技感光效,信息卡片有半透明玻璃质感,文字清晰可读,排版整齐有呼吸感,四周留有安全边距。 画面中所有信息区域、卡片、列表必须填充完整合理的内容,不得出现空白框、空白占位、横线待填写区域、空列表项、空单元格,确保是完整可用的成品海报而非待填写模板。 画面中所有数字必须精确渲染,不得错位、遗漏或编造。一张16:9横版的多模态AI与AI影视产业全景信息图海报,科技感商务风格,深蓝与紫色渐变背景,带有发光的神经网络节点和数据流线条装饰,整体高端专业。画面分为三大横向模块,版式精美,信息层次分明。

顶部居中大标题:"多模态AI与AI影视产业全景",字体粗大有力量,下方副标题:"能力爆发 · 三级落地 · 从1到N放量关键时点",字号稍小。

左侧模块(模块一):标题"近期模型密集升级",下方以时间轴或卡片形式列出5个模型升级事件,每个事件配小图标:
- "DeepSeek VC Flash专业版" 视觉理解Agent能力跃升
- "阿里万相3.0" 单次生成30秒视频
- "智谱GLM5.3 Flash" 3200亿参数 定价仅1/10
- "腾讯混元4 Preview" 7700亿参数 1M上下文
- "MiniMax H3 Max" 实时直播 跨过直播门槛

中间模块(模块二):标题"AI影视三层落地路径",用三个阶梯式或递进式卡片展示,从下到上或从左到右:
- 第一层:"AI短剧/漫剧" 标注"已大规模成熟·数百亿市场"
- 第二层:"AI长剧" 标注"《后西游记》卫视上线·标志性落地"
- 第三层:"AI电影" 标注"《三星堆》2026院线·起步潜力巨大"
每个层级用箭头连接表示递进关系。

右侧模块(模块三):标题"产业链核心标的",分为上下两部分:
- 上半部分:"视频模型工具(卖水人逻辑)" 列出:快手可灵、腾讯混元、MiniMax H3、阿里万相、智谱GLM5
- 下半部分:"AI影视内容" 列出:阅文集团、芒果超媒、博纳影业、光线传媒、掌阅科技

底部有一行标签式文字:"多模态弯道超车 · 国产模型原生优势 · 商业化空间全面打开"。

整体配色:深蓝紫色调为主,搭配青色和橙色点缀,科技感光效,信息卡片有半透明玻璃质感,文字清晰可读,排版整齐有呼吸感,四周留有安全边距。

画面中所有信息区域、卡片、列表必须填充完整合理的内容,不得出现空白框、空白占位、横线待填写区域、空列表项、空单元格,确保是完整可用的成品海报而非待填写模板。
画面中所有数字必须精确渲染,不得错位、遗漏或编造。
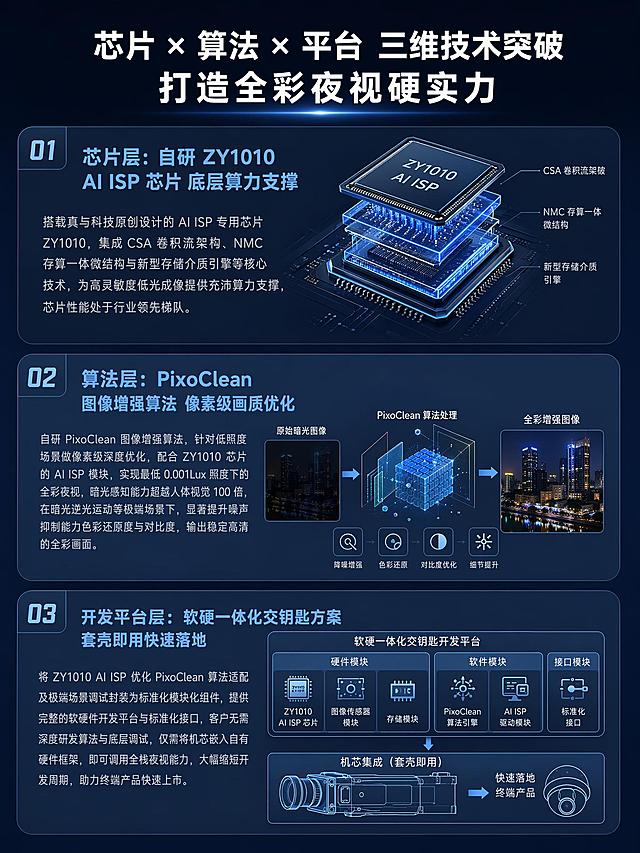
[第4屏] 详情页核心技术板块 - 三大核心技术突破。 [氛围/风格] 技术拆解科技风,精密专业,结构清晰。 [元素布局] 顶部大标题,下方分三个纵向卡片,每个卡片对应一项核心技术,从上到下依次排布。每个卡片包含技术名称、示意图区域和说明文字。芯片层可搭配芯片结构透视图,算法层搭配像素优化示意图,平台层搭配模块化架构示意图,整体信息层次分明。 [光影质感] 顶部标题高亮,每个卡片分隔清晰,示意图区域柔和打光,文字区域均匀亮度,整体明暗层级清晰,突出技术细节。 [配色色系] 全局底色 #0F172A,三个卡片背景依次用 #1E293B、#27374D、#334155 渐变区分,技术标题浅蓝色,说明文字浅灰色,示意图线框浅蓝色,整体统一有层次。 [视角构图] 通栏纵向排版,从上到下依次阅读,每个卡片占比均匀,布局稳定。 [文字版式] 顶部大标题「芯片 × 算法 × 平台 三维技术突破 打造全彩夜视硬实力」白色加粗居中; ① 芯片层卡片:标题「芯片层:自研 ZY1010 AI ISP 芯片 底层算力支撑」浅蓝色加粗,说明文字浅灰:搭载真与科技原创设计的 AI ISP 专用芯片 ZY1010,集成 CSA 卷积流架构、NMC 存算一体微结构与新型存储介质引擎等核心技术,为高灵敏度低光成像提供充沛算力支撑,芯片性能处于行业领先梯队。 ② 算法层卡片:标题「算法层:PixoClean 图像增强算法 像素级画质优化」浅蓝色加粗,说明文字浅灰:自研 PixoClean 图像增强算法,针对低照度场景做像素级深度优化,配合 ZY1010 芯片的 AI ISP 模块,实现最低 0.001Lux 照度下的全彩夜视,暗光感知能力超越人体视觉 100 倍,在暗光逆光运动等极端场景下,显著提升噪声抑制能力色彩还原度与对比度,输出稳定高清的全彩画面。 ③ 平台层卡片:标题「开发平台层:软硬一体化交钥匙方案 套壳即用快速落地」浅蓝色加粗,说明文字浅灰:将 ZY1010 AI ISP 优化 PixoClean 算法适配及极端场景调试封装为标准化模块化组件,提供完整的软硬件开发平台与标准化接口,客户无需深度研发算法与底层调试,仅需将机芯嵌入自有硬件框架,即可调用全栈夜视能力,大幅缩短开发周期,助力终端产品快速上市。 所有文字大小适中清晰,排版整齐。 [比例分辨率] 3:4竖版比例,4K分辨率,文字清晰可辨,高清画质。 [负向提示词] 变形,水印,文字错乱,文字过小,结构错误,背景杂乱[第4屏] 详情页核心技术板块 - 三大核心技术突破。
[氛围/风格] 技术拆解科技风,精密专业,结构清晰。
[元素布局] 顶部大标题,下方分三个纵向卡片,每个卡片对应一项核心技术,从上到下依次排布。每个卡片包含技术名称、示意图区域和说明文字。芯片层可搭配芯片结构透视图,算法层搭配像素优化示意图,平台层搭配模块化架构示意图,整体信息层次分明。
[光影质感] 顶部标题高亮,每个卡片分隔清晰,示意图区域柔和打光,文字区域均匀亮度,整体明暗层级清晰,突出技术细节。
[配色色系] 全局底色 #0F172A,三个卡片背景依次用 #1E293B、#27374D、#334155 渐变区分,技术标题浅蓝色,说明文字浅灰色,示意图线框浅蓝色,整体统一有层次。
[视角构图] 通栏纵向排版,从上到下依次阅读,每个卡片占比均匀,布局稳定。
[文字版式] 顶部大标题「芯片 × 算法 × 平台 三维技术突破 打造全彩夜视硬实力」白色加粗居中;
① 芯片层卡片:标题「芯片层:自研 ZY1010 AI ISP 芯片 底层算力支撑」浅蓝色加粗,说明文字浅灰:搭载真与科技原创设计的 AI ISP 专用芯片 ZY1010,集成 CSA 卷积流架构、NMC 存算一体微结构与新型存储介质引擎等核心技术,为高灵敏度低光成像提供充沛算力支撑,芯片性能处于行业领先梯队。
② 算法层卡片:标题「算法层:PixoClean 图像增强算法 像素级画质优化」浅蓝色加粗,说明文字浅灰:自研 PixoClean 图像增强算法,针对低照度场景做像素级深度优化,配合 ZY1010 芯片的 AI ISP 模块,实现最低 0.001Lux 照度下的全彩夜视,暗光感知能力超越人体视觉 100 倍,在暗光逆光运动等极端场景下,显著提升噪声抑制能力色彩还原度与对比度,输出稳定高清的全彩画面。
③ 平台层卡片:标题「开发平台层:软硬一体化交钥匙方案 套壳即用快速落地」浅蓝色加粗,说明文字浅灰:将 ZY1010 AI ISP 优化 PixoClean 算法适配及极端场景调试封装为标准化模块化组件,提供完整的软硬件开发平台与标准化接口,客户无需深度研发算法与底层调试,仅需将机芯嵌入自有硬件框架,即可调用全栈夜视能力,大幅缩短开发周期,助力终端产品快速上市。
所有文字大小适中清晰,排版整齐。
[比例分辨率] 3:4竖版比例,4K分辨率,文字清晰可辨,高清画质。
[负向提示词] 变形,水印,文字错乱,文字过小,结构错误,背景杂乱
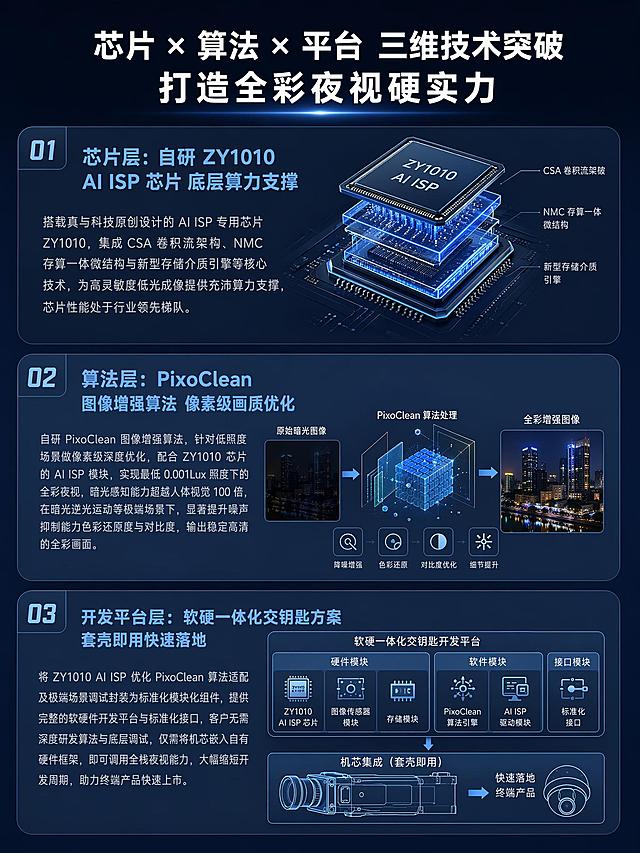
[第4屏] 详情页核心技术板块 - 三大核心技术突破。 [氛围/风格] 技术拆解科技风,精密专业,结构清晰。 [元素布局] 顶部大标题,下方分三个纵向卡片,每个卡片对应一项核心技术,从上到下依次排布。每个卡片包含技术名称、示意图区域和说明文字。芯片层可搭配芯片结构透视图,算法层搭配像素优化示意图,平台层搭配模块化架构示意图,整体信息层次分明。 [光影质感] 顶部标题高亮,每个卡片分隔清晰,示意图区域柔和打光,文字区域均匀亮度,整体明暗层级清晰,突出技术细节。 [配色色系] 全局底色 #0F172A,三个卡片背景依次用 #1E293B、#27374D、#334155 渐变区分,技术标题浅蓝色,说明文字浅灰色,示意图线框浅蓝色,整体统一有层次。 [视角构图] 通栏纵向排版,从上到下依次阅读,每个卡片占比均匀,布局稳定。 [文字版式] 顶部大标题「芯片 × 算法 × 平台 三维技术突破 打造全彩夜视硬实力」白色加粗居中; ① 芯片层卡片:标题「芯片层:自研 ZY1010 AI ISP 芯片 底层算力支撑」浅蓝色加粗,说明文字浅灰:搭载真与科技原创设计的 AI ISP 专用芯片 ZY1010,集成 CSA 卷积流架构、NMC 存算一体微结构与新型存储介质引擎等核心技术,为高灵敏度低光成像提供充沛算力支撑,芯片性能处于行业领先梯队。 ② 算法层卡片:标题「算法层:PixoClean 图像增强算法 像素级画质优化」浅蓝色加粗,说明文字浅灰:自研 PixoClean 图像增强算法,针对低照度场景做像素级深度优化,配合 ZY1010 芯片的 AI ISP 模块,实现最低 0.001Lux 照度下的全彩夜视,暗光感知能力超越人体视觉 100 倍,在暗光逆光运动等极端场景下,显著提升噪声抑制能力色彩还原度与对比度,输出稳定高清的全彩画面。 ③ 平台层卡片:标题「开发平台层:软硬一体化交钥匙方案 套壳即用快速落地」浅蓝色加粗,说明文字浅灰:将 ZY1010 AI ISP 优化 PixoClean 算法适配及极端场景调试封装为标准化模块化组件,提供完整的软硬件开发平台与标准化接口,客户无需深度研发算法与底层调试,仅需将机芯嵌入自有硬件框架,即可调用全栈夜视能力,大幅缩短开发周期,助力终端产品快速上市。 所有文字大小适中清晰,排版整齐。 [比例分辨率] 3:4竖版比例,4K分辨率,文字清晰可辨,高清画质。 [负向提示词] 变形,水印,文字错乱,文字过小,结构错误,背景杂乱[第4屏] 详情页核心技术板块 - 三大核心技术突破。
[氛围/风格] 技术拆解科技风,精密专业,结构清晰。
[元素布局] 顶部大标题,下方分三个纵向卡片,每个卡片对应一项核心技术,从上到下依次排布。每个卡片包含技术名称、示意图区域和说明文字。芯片层可搭配芯片结构透视图,算法层搭配像素优化示意图,平台层搭配模块化架构示意图,整体信息层次分明。
[光影质感] 顶部标题高亮,每个卡片分隔清晰,示意图区域柔和打光,文字区域均匀亮度,整体明暗层级清晰,突出技术细节。
[配色色系] 全局底色 #0F172A,三个卡片背景依次用 #1E293B、#27374D、#334155 渐变区分,技术标题浅蓝色,说明文字浅灰色,示意图线框浅蓝色,整体统一有层次。
[视角构图] 通栏纵向排版,从上到下依次阅读,每个卡片占比均匀,布局稳定。
[文字版式] 顶部大标题「芯片 × 算法 × 平台 三维技术突破 打造全彩夜视硬实力」白色加粗居中;
① 芯片层卡片:标题「芯片层:自研 ZY1010 AI ISP 芯片 底层算力支撑」浅蓝色加粗,说明文字浅灰:搭载真与科技原创设计的 AI ISP 专用芯片 ZY1010,集成 CSA 卷积流架构、NMC 存算一体微结构与新型存储介质引擎等核心技术,为高灵敏度低光成像提供充沛算力支撑,芯片性能处于行业领先梯队。
② 算法层卡片:标题「算法层:PixoClean 图像增强算法 像素级画质优化」浅蓝色加粗,说明文字浅灰:自研 PixoClean 图像增强算法,针对低照度场景做像素级深度优化,配合 ZY1010 芯片的 AI ISP 模块,实现最低 0.001Lux 照度下的全彩夜视,暗光感知能力超越人体视觉 100 倍,在暗光逆光运动等极端场景下,显著提升噪声抑制能力色彩还原度与对比度,输出稳定高清的全彩画面。
③ 平台层卡片:标题「开发平台层:软硬一体化交钥匙方案 套壳即用快速落地」浅蓝色加粗,说明文字浅灰:将 ZY1010 AI ISP 优化 PixoClean 算法适配及极端场景调试封装为标准化模块化组件,提供完整的软硬件开发平台与标准化接口,客户无需深度研发算法与底层调试,仅需将机芯嵌入自有硬件框架,即可调用全栈夜视能力,大幅缩短开发周期,助力终端产品快速上市。
所有文字大小适中清晰,排版整齐。
[比例分辨率] 3:4竖版比例,4K分辨率,文字清晰可辨,高清画质。
[负向提示词] 变形,水印,文字错乱,文字过小,结构错误,背景杂乱
「图片1」「图片1」「图片1」「图片1」AIGC 视频制作怎么学?先从 3 个方向了解 近几年,很多人都在重新梳理自己的技能方向。 如果你本身关注影视、广告、新媒体、短视频或数字内容创作,AIGC 视频制作可以作为一个了解方向。 学 AI 视频时,不建议只关注工具名称。 更重要的是理解一条完整的内容制作流程:从脚本、分镜、画面生成,到动画、特效、声音和剪辑,再到最后的作品呈现。 目前 AIGC 视频相关内容,可以先从 3 类场景了解: 方向 1|影视动画制作 可用于 AI 短剧、AI 动画片段、AIGC 短视频等内容练习。 方向 2|文化传媒内容 可延展到文旅宣传短片、传统文化内容、品牌传播视频等内容场景。 方向 3|教育相关内容 比如数字教学素材、动画课件、技能演示视频等。 自学时,可能会遇到知识点分散、流程不够连贯的问题。 如果想更系统地了解 AIGC 视频制作流程,可以参考结构化课程、公开教程或项目练习等学习方式,逐步熟悉相关内容。 相关学习内容通常会涉及建模、动画、特效、剪辑与项目练习等模块,便于学习者了解数字内容创作的基础流程。 不同基础的人,学习节奏和练习进度会有差异。建议结合自己的时间、兴趣、基础情况和后续规划,理性选择适合自己的学习方式。 部分学习项目也会涉及作品整理、简历表达、模拟面试等求职准备参考内容。具体学习体验、阶段性成果和后续准备情况,仍需要结合个人基础、练习投入和实际情况综合判断。 如果你正在了解 AIGC 视频制作,可以先问自己 4 个问题: 我更想做影视动画、品牌内容,还是教学素材? 我现在更需要了解工具操作,还是完整流程? 我是否需要通过项目练习整理阶段性成果? 我未来希望怎样呈现自己的能力? 先把方向想清楚,再决定怎么学,通常会更有参考价值。 #AI工具 #AI视频 #AIGC学习 #视频剪辑学习 #视频制作 #AI短剧创作 #影视动画 #数字内容创作,根据小红书内容,不要违规生成8张图,生成同意色调8张图「图片1」「图片1」「图片1」「图片1」AIGC 视频制作怎么学?先从 3 个方向了解
近几年,很多人都在重新梳理自己的技能方向。
如果你本身关注影视、广告、新媒体、短视频或数字内容创作,AIGC 视频制作可以作为一个了解方向。
学 AI 视频时,不建议只关注工具名称。
更重要的是理解一条完整的内容制作流程:从脚本、分镜、画面生成,到动画、特效、声音和剪辑,再到最后的作品呈现。
目前 AIGC 视频相关内容,可以先从 3 类场景了解:
方向 1|影视动画制作
可用于 AI 短剧、AI 动画片段、AIGC 短视频等内容练习。
方向 2|文化传媒内容
可延展到文旅宣传短片、传统文化内容、品牌传播视频等内容场景。
方向 3|教育相关内容
比如数字教学素材、动画课件、技能演示视频等。
自学时,可能会遇到知识点分散、流程不够连贯的问题。
如果想更系统地了解 AIGC 视频制作流程,可以参考结构化课程、公开教程或项目练习等学习方式,逐步熟悉相关内容。
相关学习内容通常会涉及建模、动画、特效、剪辑与项目练习等模块,便于学习者了解数字内容创作的基础流程。
不同基础的人,学习节奏和练习进度会有差异。建议结合自己的时间、兴趣、基础情况和后续规划,理性选择适合自己的学习方式。
部分学习项目也会涉及作品整理、简历表达、模拟面试等求职准备参考内容。具体学习体验、阶段性成果和后续准备情况,仍需要结合个人基础、练习投入和实际情况综合判断。
如果你正在了解 AIGC 视频制作,可以先问自己 4 个问题:
我更想做影视动画、品牌内容,还是教学素材?
我现在更需要了解工具操作,还是完整流程?
我是否需要通过项目练习整理阶段性成果?
我未来希望怎样呈现自己的能力?
先把方向想清楚,再决定怎么学,通常会更有参考价值。
#AI工具 #AI视频 #AIGC学习 #视频剪辑学习 #视频制作 #AI短剧创作 #影视动画 #数字内容创作,根据小红书内容,不要违规生成8张图,生成同意色调8张图
Ailora · 编导专用 AI 智能体 一站式短视频内容创作流程化解决方案 一、 产品定位 Ailora 是一款基于飞书多维表格深度定制,集成了 DeepSeek与豆包等大模型能力的生产力工具。它专为短视频编导、自媒体创作者、企业号运营者打造,将碎片化的 AI 对话转变为流程化、可留存、可复用的标准化流水线,无需复杂编程和代码,复制粘贴即可实现从账号定位到批量获客的全链路高效创作。 二、 核心价值:为什么选择 Ailora? 1. 资产化留存:不同于传统对话式 AI,Ailora依托飞书表格,让每一次创意、选题、文案都有据可查,形成团队独有的“内容资产库”。 2. 流程化作业:严格遵循内容创作逻辑(定位 → 选题 → 文案 → 优化),像工厂流水线一样稳定产出内容。 3. 专家级提示词:内置编导行业 2 年深耕优化的“黄金提示词”,跨越小白与专业编导之间的逻辑鸿沟。 4. 低成本高效能:极低的学习与资金成本,实现从 1 到 N 的内容批量生产。 5. 全部开源: 不对底层逻辑做任何加密。所有的多维表格架构、工作流设置、以及核心提示词(Prompt)全部对用户公开透明。这意味着您可以根据业务需求随时进行二次开发,打造真正属于自己的私有化 AI 编导大脑。 --- 三、 功能模块详述 第一阶段:战略定位与深度选题 - 【定位诊断表】:仅需单次输入,AI 自动梳理“我是谁、卖什么、解决什么痛点、服务谁”等核心维度,生成全局账号底色。 - 【爆款选题表】:内置多个爆款元素矩阵,支持方案 A/B 双模型产出。单次触发可生成超多高流量选题,确保内容既符合算法逻辑,又贴合品牌定位。 第二阶段:高转化文案创作 - 【爆款文案表】: 基于第一阶段的定位与选题,结合大模型底层逻辑,一键生成初稿。它确保了文案的架构完整,逻辑严密,且完美继承了账号的人设基因。 - 【同城实体获客表】: 针对线下商家痛点,定制化输出。一张表集成 流量型(抓眼球)、人设型(建信任)、成交型(促转化) 三大营销模型。配合高诱惑力的同城钩子,直接解决到店转化难题。 - 【开篇钩子(Hook)库】:“前 3 秒决定生死”。我们独立开发了钩子添加模块,内置了多种经过验证的黄金开头逻辑。AI 会根据你的选题,手动/自动匹配最能锁住注意力的“钩子”,确保用户在刷到你的一瞬间产生“必须看下去”的冲动。 - 【文案深度优化表】:告别 AI 感,注入编导灵魂。我们将两年的编导实战提示词(Prompt)注入其中,通过“视觉化改写”和“节奏切分”,将平铺直叙的解说词转化为五感化描述和呼吸感切分 ,制造语言的“鼓点”和张力,让每一行文字都具备极强的分镜感。 第三阶段:对标爆款与批量工业化 - 【对标文案改写】:粘贴短视频链接,通过插件一键提取文案,并结合自身定位进行“去同质化”改写,实现爆款逻辑复用。 - 【作品数据洞察】:快速抓取对标作品的点赞、播放等全维度数据,用数据指导创作方向。 - 【主页批量采集】:支持一键提取目标作者主页全部作品及其文案,支持批量化改写。 - 【关键词批量获客】:输入关键词,批量抓取抖音相关热门作品,快速捕捉行业风向。 --- 四、 持续迭代与成长计划 - 持续更新: 我们将根据短视频平台的算法变化,定期更新内置的选题库与文案模型,确保内容永远走在流量前沿。 - 持续迭代: 智能体功能将根据用户反馈不断进化。2.0 版本只是起点,未来我们将引入更多维度的插件与更深度的 AI 逻辑,持续为您降低创作门槛。 - AI算力:极低的文案提取、改写、批量获取等算力成本。(提醒:文案提取、批量提取、数据获取等功能需要AI算力,可按需购买) --- 五、 核心优势对比 暂时无法在飞书文档外展示此内容 --- 六、 结语 Ailora 2.0 不仅仅是一个 AI 工具,它是一套数字化的编导大脑。我们把最复杂的逻辑留给了提示词和表格,把最简单、最高效的创作体验留给了你。Ailora编导专用3.0更全面更高效版本持续开发中... 七、客户支持与教学中心 [ 教程中心 ] - 此处留空 [ 客服支持 ] [图片] WX:aiipgc 八、©️版权声明 1. 本工具及其内置的提示词工作流、多维表格逻辑架构均由 Ailora 团队原创开发。 2. Ailora工作流、逻辑链、Prompt享有本产品及相关技术方案的知识产权。 3. 未经正式书面授权,请勿将本工具或其核心逻辑进行二次分发、转售或用于商业牟利。 4. 感谢您对原创成果的尊重与配合。Ailora · 编导专用 AI 智能体
一站式短视频内容创作流程化解决方案
一、 产品定位
Ailora 是一款基于飞书多维表格深度定制,集成了 DeepSeek与豆包等大模型能力的生产力工具。它专为短视频编导、自媒体创作者、企业号运营者打造,将碎片化的 AI 对话转变为流程化、可留存、可复用的标准化流水线,无需复杂编程和代码,复制粘贴即可实现从账号定位到批量获客的全链路高效创作。
二、 核心价值:为什么选择 Ailora?
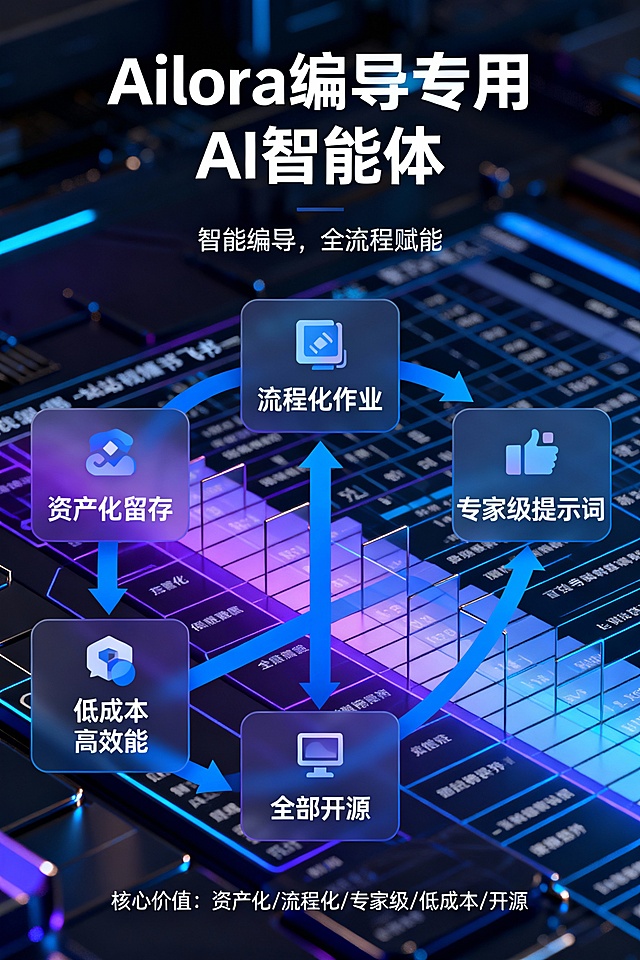
1. 资产化留存:不同于传统对话式 AI,Ailora依托飞书表格,让每一次创意、选题、文案都有据可查,形成团队独有的“内容资产库”。
2. 流程化作业:严格遵循内容创作逻辑(定位 → 选题 → 文案 → 优化),像工厂流水线一样稳定产出内容。
3. 专家级提示词:内置编导行业 2 年深耕优化的“黄金提示词”,跨越小白与专业编导之间的逻辑鸿沟。
4. 低成本高效能:极低的学习与资金成本,实现从 1 到 N 的内容批量生产。
5. 全部开源: 不对底层逻辑做任何加密。所有的多维表格架构、工作流设置、以及核心提示词(Prompt)全部对用户公开透明。这意味着您可以根据业务需求随时进行二次开发,打造真正属于自己的私有化 AI 编导大脑。

---
三、 功能模块详述
第一阶段:战略定位与深度选题
- 【定位诊断表】:仅需单次输入,AI 自动梳理“我是谁、卖什么、解决什么痛点、服务谁”等核心维度,生成全局账号底色。
- 【爆款选题表】:内置多个爆款元素矩阵,支持方案 A/B 双模型产出。单次触发可生成超多高流量选题,确保内容既符合算法逻辑,又贴合品牌定位。
第二阶段:高转化文案创作
- 【爆款文案表】: 基于第一阶段的定位与选题,结合大模型底层逻辑,一键生成初稿。它确保了文案的架构完整,逻辑严密,且完美继承了账号的人设基因。
- 【同城实体获客表】: 针对线下商家痛点,定制化输出。一张表集成 流量型(抓眼球)、人设型(建信任)、成交型(促转化) 三大营销模型。配合高诱惑力的同城钩子,直接解决到店转化难题。
- 【开篇钩子(Hook)库】:“前 3 秒决定生死”。我们独立开发了钩子添加模块,内置了多种经过验证的黄金开头逻辑。AI 会根据你的选题,手动/自动匹配最能锁住注意力的“钩子”,确保用户在刷到你的一瞬间产生“必须看下去”的冲动。
- 【文案深度优化表】:告别 AI 感,注入编导灵魂。我们将两年的编导实战提示词(Prompt)注入其中,通过“视觉化改写”和“节奏切分”,将平铺直叙的解说词转化为五感化描述和呼吸感切分 ,制造语言的“鼓点”和张力,让每一行文字都具备极强的分镜感。
第三阶段:对标爆款与批量工业化
- 【对标文案改写】:粘贴短视频链接,通过插件一键提取文案,并结合自身定位进行“去同质化”改写,实现爆款逻辑复用。
- 【作品数据洞察】:快速抓取对标作品的点赞、播放等全维度数据,用数据指导创作方向。
- 【主页批量采集】:支持一键提取目标作者主页全部作品及其文案,支持批量化改写。
- 【关键词批量获客】:输入关键词,批量抓取抖音相关热门作品,快速捕捉行业风向。

---
四、 持续迭代与成长计划
- 持续更新: 我们将根据短视频平台的算法变化,定期更新内置的选题库与文案模型,确保内容永远走在流量前沿。
- 持续迭代: 智能体功能将根据用户反馈不断进化。2.0 版本只是起点,未来我们将引入更多维度的插件与更深度的 AI 逻辑,持续为您降低创作门槛。
- AI算力:极低的文案提取、改写、批量获取等算力成本。(提醒:文案提取、批量提取、数据获取等功能需要AI算力,可按需购买)

---
五、 核心优势对比
暂时无法在飞书文档外展示此内容

---
六、 结语
Ailora 2.0 不仅仅是一个 AI 工具,它是一套数字化的编导大脑。我们把最复杂的逻辑留给了提示词和表格,把最简单、最高效的创作体验留给了你。Ailora编导专用3.0更全面更高效版本持续开发中...
七、客户支持与教学中心
[ 教程中心 ]
- 此处留空
[ 客服支持 ]
[图片]
WX:aiipgc
八、©️版权声明
1. 本工具及其内置的提示词工作流、多维表格逻辑架构均由 Ailora 团队原创开发。
2. Ailora工作流、逻辑链、Prompt享有本产品及相关技术方案的知识产权。
3. 未经正式书面授权,请勿将本工具或其核心逻辑进行二次分发、转售或用于商业牟利。
4. 感谢您对原创成果的尊重与配合。
参照这张图的低饱和深空蓝科技插画风格,生成一张新的行业现状分析信息图,竖版3:4构图,2K超清,干净高级、柔和冷光: 顶部大标题:"行业现状" 副标题小字:"AI 视频生成,已经能做出电影质感的长镜头" 画面主体是四个要点卡片,从上到下排列,每张配图标与说明: 【01 电影质感镜头已可稳定产出】 图标:相机与镜头光晕 内容:"匀速推拉、横移、缓慢跟拍这类经典镜头语言,可通过文本指令直接生成 | 景深、光影氛围感、镜头运动顺滑度相比早期版本明显提升" 【02 通用方案:分段生成 + 帧续写拼接】 图标:多段胶片帧相连的链条 内容:"取上一段画面的尾帧作为下一段参考基准 | 多段短片拼接后,视觉上接近一镜到底的长镜头效果 | 适合氛围感短片、MV、广告概念镜头创作" 【03 参考图锁定人物特征】 图标:人物轮廓与参考图对齐 内容:"单人慢动作、场景简单的镜头 | 人物外形、服装纹理稳定性大幅提升 | 网上大量惊艳的AI影视演示片段基本都是这类场景" 【04 关键限制提示】 图标:断开的长镜头符号 内容:"AI可以做出看似流畅的电影感长镜头,但本质是分段拼接的'伪长镜头' | 一旦进入完整叙事,全行业共同的技术局限就会显现" 保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。参照这张图的低饱和深空蓝科技插画风格,生成一张新的行业现状分析信息图,竖版3:4构图,2K超清,干净高级、柔和冷光:

顶部大标题:"行业现状"
副标题小字:"AI 视频生成,已经能做出电影质感的长镜头"

画面主体是四个要点卡片,从上到下排列,每张配图标与说明:

【01 电影质感镜头已可稳定产出】
图标:相机与镜头光晕
内容:"匀速推拉、横移、缓慢跟拍这类经典镜头语言,可通过文本指令直接生成 | 景深、光影氛围感、镜头运动顺滑度相比早期版本明显提升"

【02 通用方案:分段生成 + 帧续写拼接】
图标:多段胶片帧相连的链条
内容:"取上一段画面的尾帧作为下一段参考基准 | 多段短片拼接后,视觉上接近一镜到底的长镜头效果 | 适合氛围感短片、MV、广告概念镜头创作"

【03 参考图锁定人物特征】
图标:人物轮廓与参考图对齐
内容:"单人慢动作、场景简单的镜头 | 人物外形、服装纹理稳定性大幅提升 | 网上大量惊艳的AI影视演示片段基本都是这类场景"

【04 关键限制提示】
图标:断开的长镜头符号
内容:"AI可以做出看似流畅的电影感长镜头,但本质是分段拼接的'伪长镜头' | 一旦进入完整叙事,全行业共同的技术局限就会显现"

保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。
参照这张图的低饱和深空蓝科技插画风格,生成一张新的技术边界分析信息图,竖版3:4构图,2K超清,五个卡片紧凑排列、文字精炼易读: 顶部大标题:"五大行业共性技术边界" 副标题小字:"AI 电影感背后的真实技术天花板" 画面从上到下五个编号卡片(编号金色圆标 + 图标 + 标题 + 简短要点): 【边界1:单次生成存在时长上限】 图标:胶片时长刻度 要点:"所有主流模型单次原生生成都有固定时长限制 | 做更长镜头只能分段续写拼接 | 跨片段会出现特征漂移:五官、发色、服装纹理、场景色温缓慢变化 | 原因:没有全局长期记忆,误差逐段累积" 【边界2:快速动态与人物交互易失真】 图标:人物肢体轮廓断裂 要点:"慢动作单人场景稳定 | 一旦转身、快速移动、抬手抓取、多人互动,容易肢体畸形、五官错位 | 底层原因:基于像素概率拟合,没有内置真实物理规则 | 物体遮挡后凭空消失、道具提前动作" 【边界3:时序漂移 —— 长时序核心难题】 图标:逐渐扭曲的墙面纹理 要点:"逐帧生成存在累积帧误差,时间拉长后误差持续放大 | 物体位置纹理光影缓慢无逻辑变化 | 墙面地面纹理扭曲流动 | 镜头轨迹中途无理由变速 | 时空注意力窗口存在上限,单纯优化提示词无法根治" 【边界4:多人同框、复杂空间叙事难度极高】 图标:多人站位错乱 要点:"双人对话、多人走位、复杂调度场景缺陷明显放大 | 视线错位、位置随机互换、肢体互相穿模 | 而对手戏与空间调度正是电影叙事的核心" 【边界5:音画同步、画面文字与量产成本约束】 图标:声波与文字乱码 要点:"无法原生同步生成匹配的人声与环境音效,唇形对齐需后期调整 | 画面内文字稳定性差,招牌、印花、字幕容易扭曲乱码 | 合格镜头需要大量重复试错,算力消耗高,规模化生产成本不低" 保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。参照这张图的低饱和深空蓝科技插画风格,生成一张新的技术边界分析信息图,竖版3:4构图,2K超清,五个卡片紧凑排列、文字精炼易读:

顶部大标题:"五大行业共性技术边界"
副标题小字:"AI 电影感背后的真实技术天花板"

画面从上到下五个编号卡片(编号金色圆标 + 图标 + 标题 + 简短要点):

【边界1:单次生成存在时长上限】
图标:胶片时长刻度
要点:"所有主流模型单次原生生成都有固定时长限制 | 做更长镜头只能分段续写拼接 | 跨片段会出现特征漂移:五官、发色、服装纹理、场景色温缓慢变化 | 原因:没有全局长期记忆,误差逐段累积"

【边界2:快速动态与人物交互易失真】
图标:人物肢体轮廓断裂
要点:"慢动作单人场景稳定 | 一旦转身、快速移动、抬手抓取、多人互动,容易肢体畸形、五官错位 | 底层原因:基于像素概率拟合,没有内置真实物理规则 | 物体遮挡后凭空消失、道具提前动作"

【边界3:时序漂移 —— 长时序核心难题】
图标:逐渐扭曲的墙面纹理
要点:"逐帧生成存在累积帧误差,时间拉长后误差持续放大 | 物体位置纹理光影缓慢无逻辑变化 | 墙面地面纹理扭曲流动 | 镜头轨迹中途无理由变速 | 时空注意力窗口存在上限,单纯优化提示词无法根治"

【边界4:多人同框、复杂空间叙事难度极高】
图标:多人站位错乱
要点:"双人对话、多人走位、复杂调度场景缺陷明显放大 | 视线错位、位置随机互换、肢体互相穿模 | 而对手戏与空间调度正是电影叙事的核心"

【边界5:音画同步、画面文字与量产成本约束】
图标:声波与文字乱码
要点:"无法原生同步生成匹配的人声与环境音效,唇形对齐需后期调整 | 画面内文字稳定性差,招牌、印花、字幕容易扭曲乱码 | 合格镜头需要大量重复试错,算力消耗高,规模化生产成本不低"

保持低饱和深空蓝渐变背景、柔和冷光、2.5D扁平插画质感、卡片浅色边框与轻投影、干净高级、文字清晰层级分明。